给 Vercel AI SDK 应用加上多智能体编排
架构由文中链接的 Next.js 示例支撑。展示的是两个库如何在同一个路由里组合;规模未做测试。
我最近撞了堵墙。手上有个能跑的 AI SDK 应用——streamText、useChat,一整套都在——然后我需要它做一件单个智能体做不到的事:让一个智能体研究某个主题,再把研究结果交给第二个智能体来写作。
这事你可以手动做。把两次 generateText 调用粘起来,把上下文传来传去,再处理好出错的情况。但一旦你想要一个协调器来决定哪些任务按什么顺序跑,或者要三个智能体共享状态,你就开始在写编排基础设施了。我不想写编排基础设施。
于是我把 open-multi-agent(OMA)接进了一个 Next.js API 路由、放在 AI SDK 旁边,结果两个库配合得挺好。下面是怎么做的。
编排层在 AI SDK 之上的位置
AI SDK 和 OMA 干的是不同的活,重叠不多。
| Vercel AI SDK | open-multi-agent | |
|---|---|---|
| 它是什么 | LLM 调用层 + 流式 UI | 多智能体编排层 |
| 核心强项 | 提供方中立的模型调用、useChat、streamText、结构化输出 | runTeam()——从目标拆解任务、依赖调度、共享内存 |
| 智能体模型 | 带工具循环的单智能体(ToolLoopAgent,跑到 stopWhen 为止) | 由协调器规划的一组智能体 |
| 流式 | token 增量一路送到浏览器(toUIMessageStream + createUIMessageStreamResponse) | Agent.stream() 与 onAgentStream,按轮次和按工具调用 |
AI SDK 对接模型、流式输出 token。OMA 坐在它上面一层:给定一个目标和一组智能体,它把目标拆成任务、按依赖顺序跑、再收集结果。两者可以共用同一个 API 路由。
我们要搭什么
一个 Next.js 聊天应用。用户输入一个主题,两个智能体协作产出一篇有研究支撑的文章,结果通过 useChat 流式回传。
Browser (useChat) | vPOST /api/chat | +-- Phase 1: OMA runTeam() | coordinator decomposes goal | -> researcher agent gathers info | -> writer agent drafts article | (shared memory passes context between agents) | +-- Phase 2: AI SDK streamText() | streams the team's output to the browser | vuseChat renders streamed response阶段一:OMA 跑这个团队。一个协调器智能体(由 runTeam 自动创建)分析目标、产出一份任务计划、再执行它。researcher 的产出落进共享内存,于是 writer 能引用它。
阶段二:协调器的最终产出被接进 AI SDK 的 streamText,再通过 useChat 流式送到浏览器。这就是 OMA 完成后的团队结果与 AI SDK 流式协议之间的桥。
第 1 步:项目搭建
mkdir with-vercel-ai-sdk && cd with-vercel-ai-sdk先确认 Node 版本。AI SDK 7 要求 Node.js 22 或更高;OMA core 自身的底线是 Node 20,因此两者合起来落在 22。
package.json:
{ "private": true, "scripts": { "dev": "next dev", "build": "next build" }, "dependencies": { "@ai-sdk/openai-compatible": "^3.0.0", "@ai-sdk/react": "^4.0.0", "@open-multi-agent/core": "^1.18.0", "ai": "^7.0.0", "next": "^16.0.0", "react": "^19.0.0", "react-dom": "^19.0.0" }}OMA 把 ai 声明为可选 peer,范围是 ^5.0.0 || ^6.0.0 || ^7.0.0,所以一个还停在旧版 AI SDK 的应用不必先升级才能加上编排。本文跟随的示例用的是 7。
这里用 @ai-sdk/openai-compatible,是因为这个 demo 指向 DeepSeek。如果你直接用 Anthropic 或 OpenAI,把它换成它们各自的提供方包就行。
npm install第 2 步:后端
一个 API 路由,两个阶段。有意思的地方在于这套集成需要的胶水代码有多少。
app/api/chat/route.ts:
import {  streamText,  convertToModelMessages,  createUIMessageStreamResponse,  toUIMessageStream,  type UIMessage,} from 'ai'import { createOpenAICompatible } from '@ai-sdk/openai-compatible'import { OpenMultiAgent } from '@open-multi-agent/core'import type { AgentConfig } from '@open-multi-agent/core'
export const maxDuration = 360
// --- Provider setup (swap this for your preferred LLM) ---const BASE_URL = 'https://api.deepseek.com'const MODEL = 'deepseek-v4-flash'
const provider = createOpenAICompatible({  name: 'deepseek',  baseURL: `${BASE_URL}/v1`,  apiKey: process.env.DEEPSEEK_API_KEY,})
// --- Agent definitions ---const researcher: AgentConfig = {  name: 'researcher',  model: MODEL,  provider: 'openai',  baseURL: BASE_URL,  apiKey: process.env.DEEPSEEK_API_KEY,  systemPrompt: `You are a research specialist. Given a topic, provide thorough,factual research with key findings, relevant data points, and important context.Be concise but comprehensive. Output structured notes, not prose.`,  maxTurns: 3,  temperature: 0.2,}
const writer: AgentConfig = {  name: 'writer',  model: MODEL,  provider: 'openai',  baseURL: BASE_URL,  apiKey: process.env.DEEPSEEK_API_KEY,  systemPrompt: `You are an expert writer. Using research from team members(available in shared memory), write a well-structured, engaging articlewith clear headings and concise paragraphs.`,  maxTurns: 3,  temperature: 0.4,}
OMA 里的 provider: 'openai' 意思是「用 OpenAI 兼容的 chat completions API」。它能配 DeepSeek、Ollama、vLLM、LM Studio、OpenRouter、Groq,或任何其他说这套协议的服务。DeepSeek 也有内置快捷方式(provider: 'deepseek' + DEEPSEEK_API_KEY)会替你填好 base URL;上面写成显式形式,是因为示例这样写,端点也就一直摆在明面上。
一条模型名的提醒:deepseek-chat 与 deepseek-reasoner 已于 2026-07-24 下线。当前的模型 id 是 deepseek-v4-flash 与 deepseek-v4-pro。
接着是请求处理器:
function extractText(message: UIMessage): string {  return message.parts    .filter((p): p is { type: 'text'; text: string } => p.type === 'text')    .map((p) => p.text)    .join('')}
export async function POST(req: Request) {  const { messages }: { messages: UIMessage[] } = await req.json()  const lastText = extractText(messages.at(-1)!)
  // --- Phase 1: OMA multi-agent orchestration ---  const orchestrator = new OpenMultiAgent({    defaultModel: MODEL,    defaultProvider: 'openai',    defaultBaseURL: BASE_URL,    defaultApiKey: process.env.DEEPSEEK_API_KEY,  })
  const team = orchestrator.createTeam('research-writing', {    name: 'research-writing',    agents: [researcher, writer],    sharedMemory: true,  })
  const teamResult = await orchestrator.runTeam(    team,    `Research and write an article about: ${lastText}`,    // Execution routing sends a short goal down the single-agent path. An    // explicit mode outranks the router, so this keeps the demo on the    // researcher + writer team topology.    { mode: 'team' },  )
  // The team path publishes the synthesized answer under 'coordinator'; the  // single-agent path publishes it under the winning agent's own name. Read  // both so this route survives whichever topology runs.  const teamOutput =    teamResult.agentResults.get('coordinator')?.output    ?? teamResult.agentResults.get('writer')?.output    ?? ''
  // A failed run still leaves the coordinator's unparsed plan under  // 'coordinator', so check `success` rather than testing for an empty string.  if (!teamResult.success || teamOutput === '') {    return new Response(      `The agent team did not produce an article: ${        teamResult.errorInfo?.message ?? teamResult.status?.code ?? 'unknown error'      }`,      { status: 500 },    )  }
  // --- Phase 2: Stream result via Vercel AI SDK ---  const result = streamText({    model: provider(MODEL),    system: `You are presenting research from a multi-agent team.The team has already done the work. Relay their output faithfullyin a well-formatted way.
## Team Output${teamOutput}`,    messages: await convertToModelMessages(messages),  })
  return createUIMessageStreamResponse({    stream: toUIMessageStream({ stream: result.fullStream }),  })}
mode: 'team' 是一次执行路由覆盖。OMA 会为 runTeam() 在「单智能体」与「协调器规划的团队」两种拓扑之间做选择,而这样一句简短的目标会被路由到单智能体;显式指定的 mode 优先级高于路由器,因此本演示运行的正是本文所述的团队拓扑。
success 检查出于相关的理由:运行失败时,协调器那份未解析成功的计划仍留在 'coordinator' 键下,因此仅读取该键,可能把规划阶段的草稿当作文章流式发送给用户。
如果你当初是在 AI SDK 6 上写的这个路由,挪动的就是最后一行。result.toUIMessageStreamResponse() 在 AI SDK 7 里已标记废弃,改用独立的 toUIMessageStream 与 createUIMessageStreamResponse 两个 helper,并计划在下一个大版本移除。
runTeam() 内部干的事:
- 一个协调器智能体收到目标,外加一份有界的团队清单——每个智能体的名称、模型、角色摘要、能力与工具
- 一次模型调用产出一个 JSON 任务规格数组——标题、描述、指派对象、
dependsOn TaskQueue载入这份计划并解析dependsOn依赖边。一个任务的依赖一旦落定就进入就绪状态,因此互不相干的分支并行跑;并发的裁决权在AgentPool的信号量。- 每个智能体把自己的产出写进
SharedMemory,于是 writer 能看到 researcher 找到了什么 - 协调器的第二次调用把已完成的任务产出综合成最终答案
你定义智能体和一个目标。协调器决定任务图。它只在执行前规划一次,运行途中不会再被问第二遍。
第 3 步:前端
@ai-sdk/react 的 useChat 负责流式,它的接口形状值得在移植旧组件之前先读一遍。它返回 messages、sendMessage、status 和 error——没有内置的 handleSubmit 或 input 状态,消息文本落在 parts 里而不是一个 content 字符串。也没有 loading 布尔值:status 的取值是 'ready' | 'submitted' | 'streaming' | 'error',其余状态由你自己推导。
app/page.tsx:
'use client'
import { useState } from 'react'import { useChat } from '@ai-sdk/react'
export default function Home() {  const { messages, sendMessage, status, error } = useChat()  const [input, setInput] = useState('')
  const isLoading = status === 'submitted' || status === 'streaming'
  const handleSubmit = async (e: React.FormEvent) => {    e.preventDefault()    if (!input.trim() || isLoading) return    const text = input    setInput('')    await sendMessage({ text })  }
  return (    <main style={{ maxWidth: 720, margin: '0 auto', padding: '32px 16px' }}>      <h1>Research Team</h1>
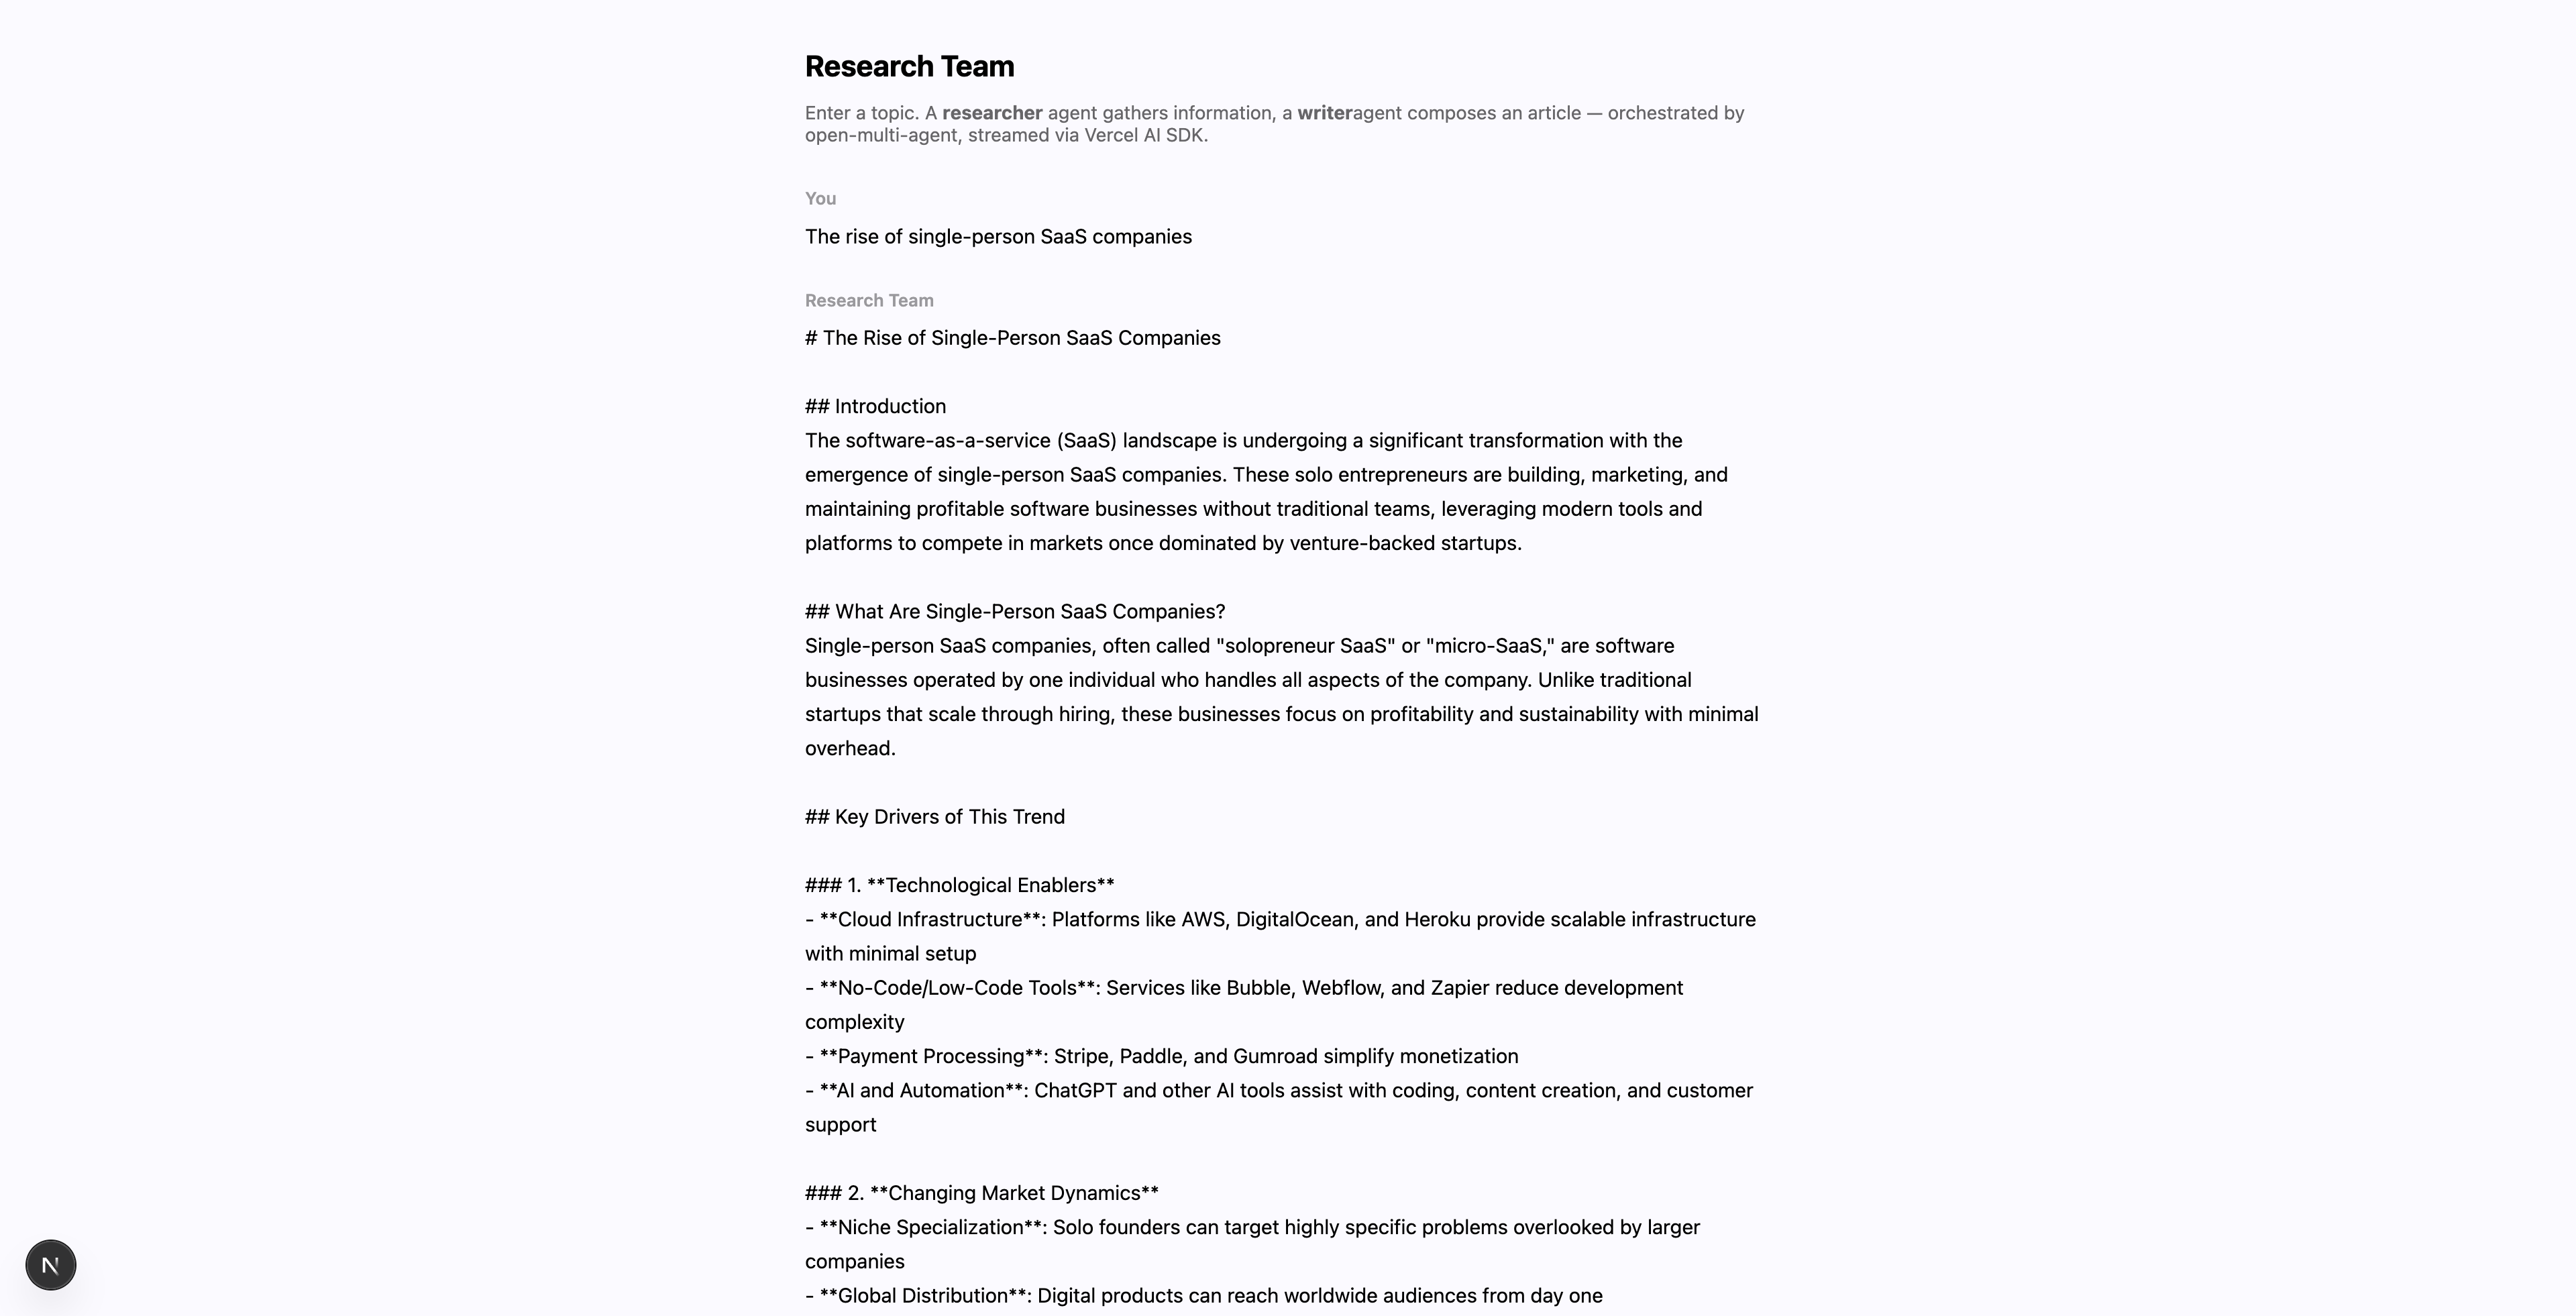
      {messages.map((m) => (        <div key={m.id} style={{ marginBottom: 24 }}>          <strong>{m.role === 'user' ? 'You' : 'Research Team'}</strong>          <div style={{ whiteSpace: 'pre-wrap' }}>            {m.parts              .filter(                (p): p is { type: 'text'; text: string } =>                  p.type === 'text',              )              .map((p) => p.text)              .join('')}          </div>        </div>      ))}
      {isLoading && status === 'submitted' && (        <p>Agents are collaborating -- this takes a few minutes...</p>      )}
      {error && <p style={{ color: 'red' }}>Error: {error.message}</p>}
      <form onSubmit={handleSubmit} style={{ display: 'flex', gap: 8 }}>        <input          value={input}          onChange={(e) => setInput(e.target.value)}          placeholder="Enter a topic to research..."          disabled={isLoading}          style={{ flex: 1, padding: '10px 14px' }}        />        <button type="submit" disabled={isLoading || !input.trim()}>          Send        </button>      </form>    </main>  )}
第 4 步:跑起来
export DEEPSEEK_API_KEY=sk-...npm run dev打开 http://localhost:3000 试一个主题。
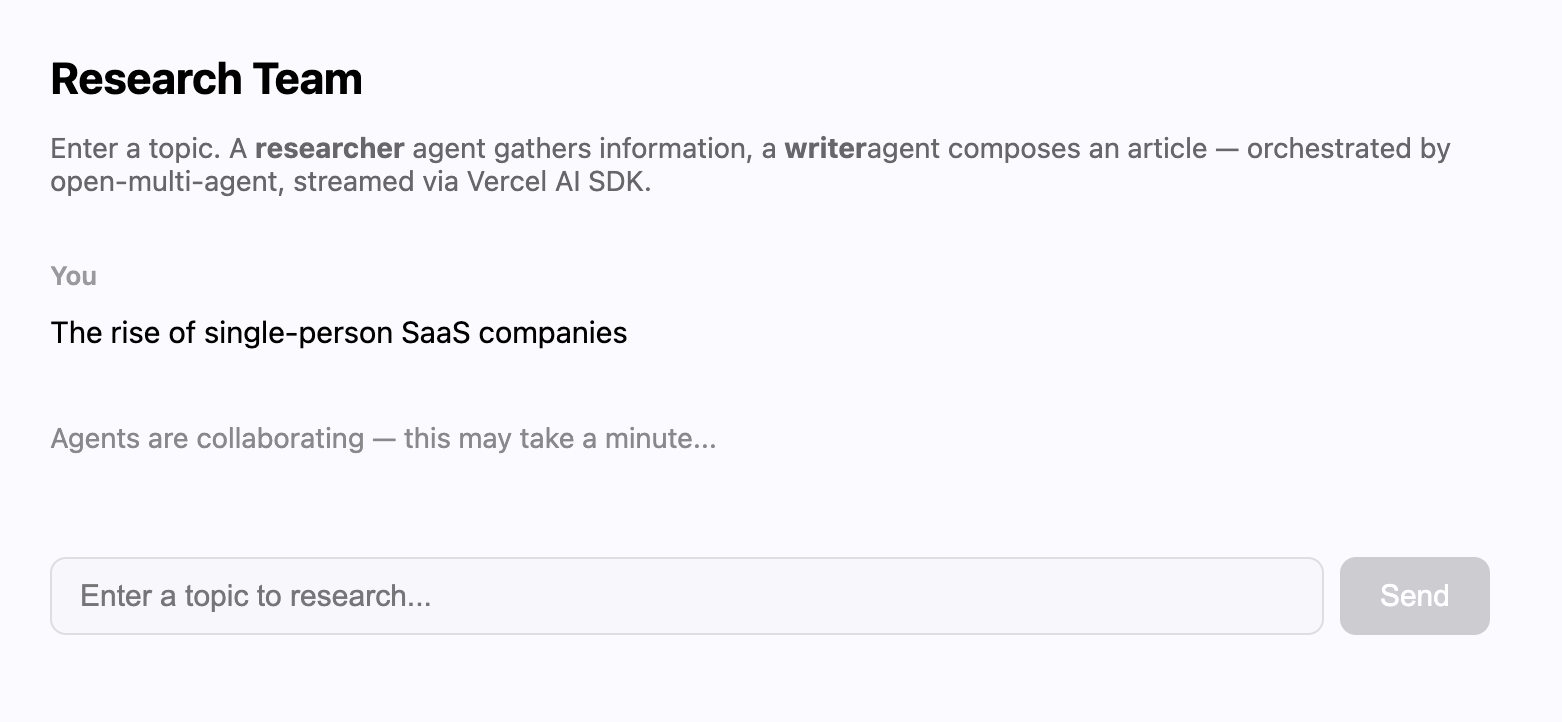
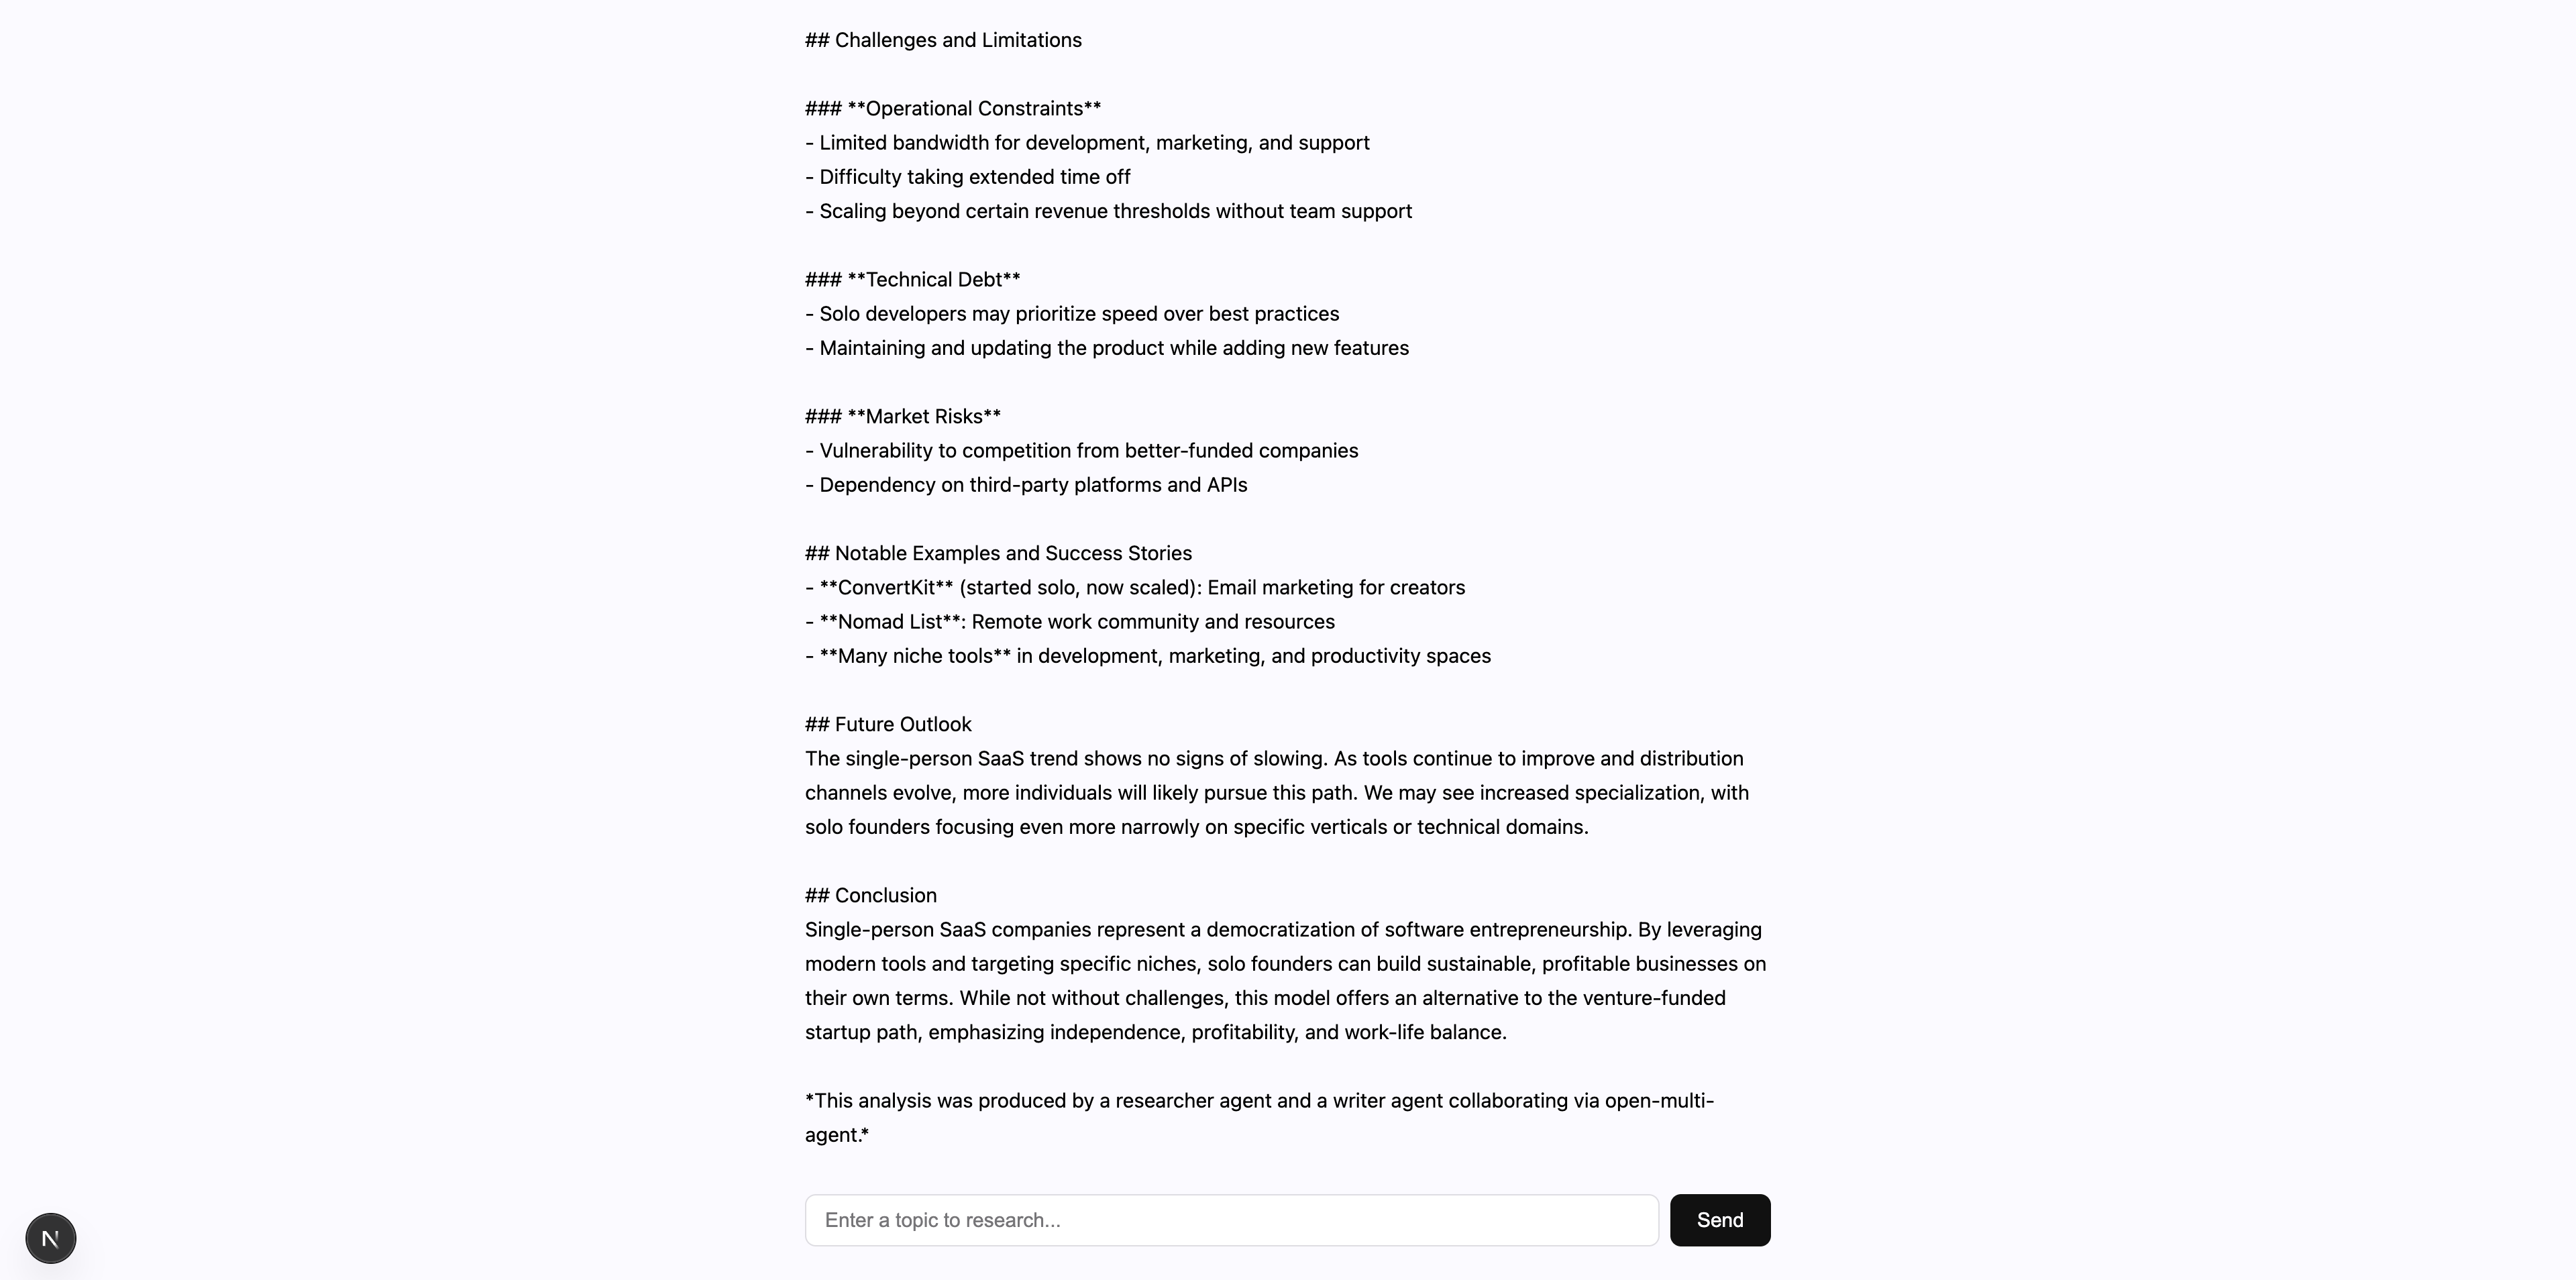
出结果前会有一段等待。整个编排阶段必须全部结束,streamText 才拿得到第一个字符。这正是上面那个 status === 'submitted' 分支要渲染一句提示、而不是留一个空框的原因。在 deepseek-v4-flash 上,思考模式保持模型默认开启,对上面这个主题实测七次,耗时 137 至 311 秒(中位数 217 秒),测试机位于中国境内;区间宽度取决于模型这一次决定写多长的文章。等阶段二启动,文章便逐 token 输出。
有个坑:@ai-sdk/openai 直接调用得到的 provider 解析的是 OpenAI 的 Responses API——provider('gpt-4o') 给你的是一个 Responses 模型,不是 Chat Completions 模型。如果你的提供方不支持那个端点,就改用 @ai-sdk/openai-compatible,或者显式调 provider.chat('model-name')。我在这上面烧掉了大概 20 分钟。
底层:一次请求在编排器里的完整路径
完整的请求生命周期:
useChat带着消息历史 POST 到/api/chatrunTeam()启动。协调器智能体收到目标与团队清单。- 协调器通过一次 LLM 调用产出一份任务计划(带指派对象与
dependsOn的 JSON 规格) TaskQueue解析依赖边,开始把就绪的任务发出去- researcher 智能体跑起来,产出进
SharedMemory - writer 智能体跑起来(从共享内存读 researcher 的产出),产出文章
- 协调器在第二次调用里综合出最终产出
streamText()接过那份产出,由toUIMessageStream+createUIMessageStreamResponse送上 AI SDK 的线缆协议useChat在浏览器里渲染这些 token
第 3-7 步发生在 runTeam() 内部。那正是 OMA 体现价值的地方——你声明智能体和一个目标,它来处理拆解、排序和状态传递。
什么在流式输出,以及粒度如何
两个库都在说「流式」,指的却不是同一件事,所以有必要把各处的粒度讲准。
在 OMA 这一侧,Agent.stream(input, runOptions?) 返回 AsyncGenerator<StreamEvent>,OrchestratorConfig.onAgentStream 则把同一批事件带上智能体名推送出来。配置这个回调,会把经任务队列派发的每个 worker 智能体从 agent.run() 切换到 agent.stream(),runTeam() 与 runTasks() 都在覆盖范围内。OpenMultiAgent.runAgent() 没有流式形式,它始终等待一个完整的 AgentRunResult。
粒度是按轮次和按工具调用,不是 token 增量。智能体循环调的是 adapter.chat(),从不调 adapter.stream(),所以一个 text 事件承载的是这一轮模型调用返回后的整轮文本,再加上每个被请求的调用一个 tool_use、每个完成的调用一个 tool_result。token 增量在更下面一层的 LLMAdapter.stream() 上,框架的执行路径并不调用它。
还有两处不在 onAgentStream 覆盖范围内:协调器的拆解与最终综合都走 agent.run(),delegate_to_agent 的子运行同样如此。落到上面那个路由,意味着浏览器在团队结果拿到手、streamText 启动之前什么都看不到——这正是阶段二存在的意义。如果你希望这段等待能显示进度,就把 onAgentStream 接进你自己的 UI 流,把每个智能体的轮次与工具调用随到随渲染。
Egress policy 到 AI SDK bridge 为止
把这两个库组合起来还有第二种方式。你可以不给 OMA 单独的提供方凭证,而是让一个 OMA 智能体走 AI SDK 的模型:
import { openai } from '@ai-sdk/openai'import { AISdkAdapter } from '@open-multi-agent/core/ai-sdk'
const researcher: AgentConfig = {  name: 'researcher',  model: 'gpt-4o',  adapter: new AISdkAdapter(openai('gpt-4o')),  systemPrompt: 'You are a research specialist.',}
设了 adapter 之后,该智能体的 provider、apiKey、baseURL 和 region 都会被忽略。混合团队照常工作:只有带 adapter 的智能体走 AI SDK。
这条路径带着一个约束。v1.16 加入的 egressPolicy 限制 OMA 内置 LLM adapter 可以访问的源——mode: 'offline' 只允许回环地址,mode: 'allowlist' 只允许列出的 HTTP(S) 源。而 AI SDK 的 model 是一个由应用提供的不透明传输层,它没有向 OMA 暴露可靠的目标与传输契约。因此一旦配置了 egressPolicy,OMA 会在调用之前直接拒绝 AISdkAdapter,而不是声称自己约束了一个它根本没看见的请求。失败是关闭式且显式的——稳定错误码 EGRESS_POLICY_UNSUPPORTED,一个不成功的智能体结果,带 status.code: 'rejected' 和 errorInfo.kind: 'validation',并且不重试,因为再试一次也不会让策略变宽。
同一条规则适用于任何自定义 LLMAdapter,包括你用 OMA 的 adapter 类构造出来的那种。如果你需要在这座桥下面有一道出口边界,它应该落在提供方自己的传输控制或者基础设施防火墙上。
本文那个两阶段路由不受影响:OMA 跑在内置的 openai adapter 上、带显式 baseURL,那是 egressPolicy 会强制执行的一个面。
什么时候需要在 AI SDK 之上加一层编排器
单用 AI SDK 能搞定大多数单智能体的活:聊天机器人、RAG、工具调用智能体、结构化抽取。如果一个智能体在一轮对话循环里就能把活干完,那加 OMA 只是平添复杂度。
该加 OMA 的时候是你需要多个智能体协作——研究 + 写作的团队、多视角代码评审、扇出式数据采集,任何一个智能体的产出要喂给另一个、而且那张依赖图你又不想写死的场景。
权衡总归是有的,每个库都有:
| AI SDK | OMA | |
|---|---|---|
| 提供方支持 | 设计上提供方中立;官方 + 社区的提供方包 | 13 个内置快捷方式(Anthropic、OpenAI、Azure OpenAI、Gemini、Bedrock、Copilot、Grok、DeepSeek、Doubao、Hunyuan、MiniMax、MiMo、Qiniu),外加任何 OpenAI 兼容端点 |
| 预算上限 | stopWhen / stepCountIs 是步数条件 | 运行级 maxTokenBudget,在轮次与任务边界处检查 |
| 可观测性 | experimental_telemetry 发出 OpenTelemetry span | onProgress / onTrace / onAgentStream 回调,外加一个离线 Run Viewer,把已结束的运行渲染成任务 DAG 与 span 瀑布图 |
OMA 的面是编排:从目标拆解、依赖调度、共享内存、一个受信号量约束的智能体池。AI SDK 的面是模型调用,以及通往浏览器的那条线。两者互不替代,这正是上面那个路由把它们一起跑起来的原因。
完整示例
可运行的代码在 open-multi-agent 仓库里:
克隆仓库,在根目录 npm install,再到示例目录 npm install 并设好 DEEPSEEK_API_KEY。npm run dev 会通过 predev 脚本先构建 OMA 再启动 Next.js,不需要另外一步构建。
如果多智能体编排对你还很新,单智能体示例可能是个更好的起点。